America/Sao_Paulo
Posts

Kafka: Conceitos Fundamentais e Primeiros Passos na Prática

February 1, 2025
Cover foto.
Já imaginou como grandes empresas como Netflix, Uber e LinkedIn processam milhões de eventos por segundo em tempo real? Desde a recomendação de filmes até a atualização de corridas em tempo real, o processamento contínuo de dados é essencial para oferecer experiências rápidas e eficientes aos usuários. Esse tipo de processamento é conhecido como event streaming, uma abordagem que permite capturar, processar e armazenar fluxos contínuos de dados à medida que eles acontecem. Entre as tecnologias que possibilitam esse modelo, o Apache Kafka se destaca como uma das soluções mais populares e robustas. O Kafka é uma plataforma distribuída de event streaming projetada para lidar com grandes volumes de dados em tempo real, garantindo alta disponibilidade, escalabilidade e desempenho. Empresas como Twitter, Netflix e Airbnb utilizam essa tecnologia para monitoramento de sistemas, processamento de logs, análise de dados em tempo real e muitas outras aplicações. Neste post, você aprenderá os conceitos fundamentais do Kafka e verá como configurar um cluster local para entender na prática como ele funciona. Vamos lá?
Anteriormente definimos o kafka como uma plataforma de streaming de eventos, mas o que exatamente são esses eventos? Um evento é um registro de algum acontecimento, a representação de um fato, também podem ser chamados de mensagens ou registros na documentação do kafka Quando interagimos com o Kafka fazemos isso lendo ou escrevendo eventos para ele. Uma propriedade importante de um evento é que ele pode ser visto como um registro em um log, ou seja, ele é persistente e imutável. Quando escutamos a palavra "log", é comum pensarmos nos registros de texto que geramos em uma aplicação para que possamos observar sua execução. No entanto quando trabalhamos com o Kafka devemos imaginar um log como uma abstração de armazenamento de dados, recomendo a leitura do seguinte post que aborda o assunto com a riqueza de detalhes que ele merece. Eventos no kafka tem três campos principais: uma chave, um valor e um timestamp. Além desses campos temos ainda headers opcionais para adicionar metadados. O dado a seguir é um exemplo de evento:
{
  "key": "Daniel",
  "value": "Entrou em sua conta",
  "timestamp": "01-02-2025 8:52:32 AM GMT-03:00"
}
O Apache Kafka foi desenvolvido para atuar como um cluster, isso é, coordenando diversos nós executando a mesma aplicação para garantir tolerância a falhas e escalabilidade. Dessa forma é possível escalar o cluster horizontalmente adicionando novos nós caso seja necessário um aumento na performance, ou então adicionar mais garantias de redundância, ja que se um dos nós falharem ele é capaz de acionar outro nó para atuar em seu lugar. Na forma mais tradicional de operar um cluster de Apache Kafka é necessário instanciar uma aplicação extra separadamente chamada Apache ZooKeeper. Esse componente fica responsável principalmente por realizar um conscenso entre os nós do cluster sobre quem serão os líderes de cada partição e gerenciar os metadados do cluster. No entanto, a partir da versão 3.3 o Kafka da a possibilidade de utilizar o KRaft como protocolo de consenso. Essa opção elimina a necessidade de instanciar uma aplicação como o ZooKeeper separadamente pois a lógica já está inclusa no próprio Kafka, simplificando o processo de criar um cluster. Ao utilizar o KRaft, um nó de um cluster Kafka pode atuar em dois papeis distintos: como broker e/ou como um controller. Um broker é uma instância rodando Kafka que atua gerenciando eventos, já um controller atua armazenando metadados do cluster e realizando papeis de consenso entre os nós.
Topics .
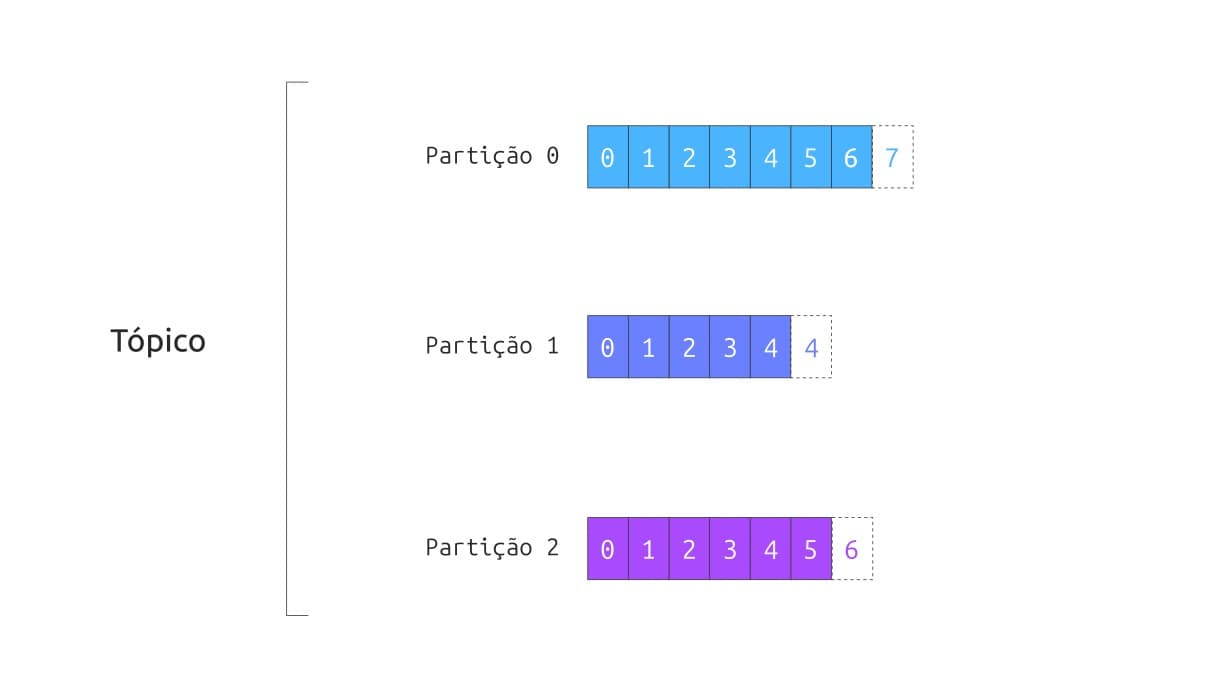
Quando consumimos ou produzimos mensagens para o Kafka devemos informar o nome de um tópico, que atua como uma espécie de diretório de sistema de arquivos onde são armazenados os eventos de uma mesma "categoria". Internamente o tópico é subdividido em partições enumeradas de 0 a N-1, onde cada partição é um log imutável de eventos. Ao armazenar um evento em uma partição ele recebe um offset, que é um valor inteiro incremental e único de cada evento naquela partição. Cada partição começa no offset 0 e incrementa seu valor à cada evento armazenado. A lógica aplicada para definir qual partição deve receber cada evento gerado e feita de forma similar a como é determinado o bucket ao qual um valor deve ser armazenado dado sua chave em um hash table. Ou seja, é feito um hash da chave do evento, e o resto da divisão pelo número de partições é o número partição em que ele deve ser armazenado. Isso faz com que eventos com a mesma chave sejam anexados a mesma partição na ordem em que são inseridos. Repare que não existe uma garantia de ordem dos eventos de um tópico no geral, mas sim de eventos com a mesma chave em uma partição. O número de partições de um tópico deve ser configurado no momento de sua criação. Após a criação do tópico é possível aumentar o número de partições, mas ao fazer isso perdemos as garantias de ordenação dos eventos com uma mesma chave que mencionamos anteriormente.
Partition Replication .
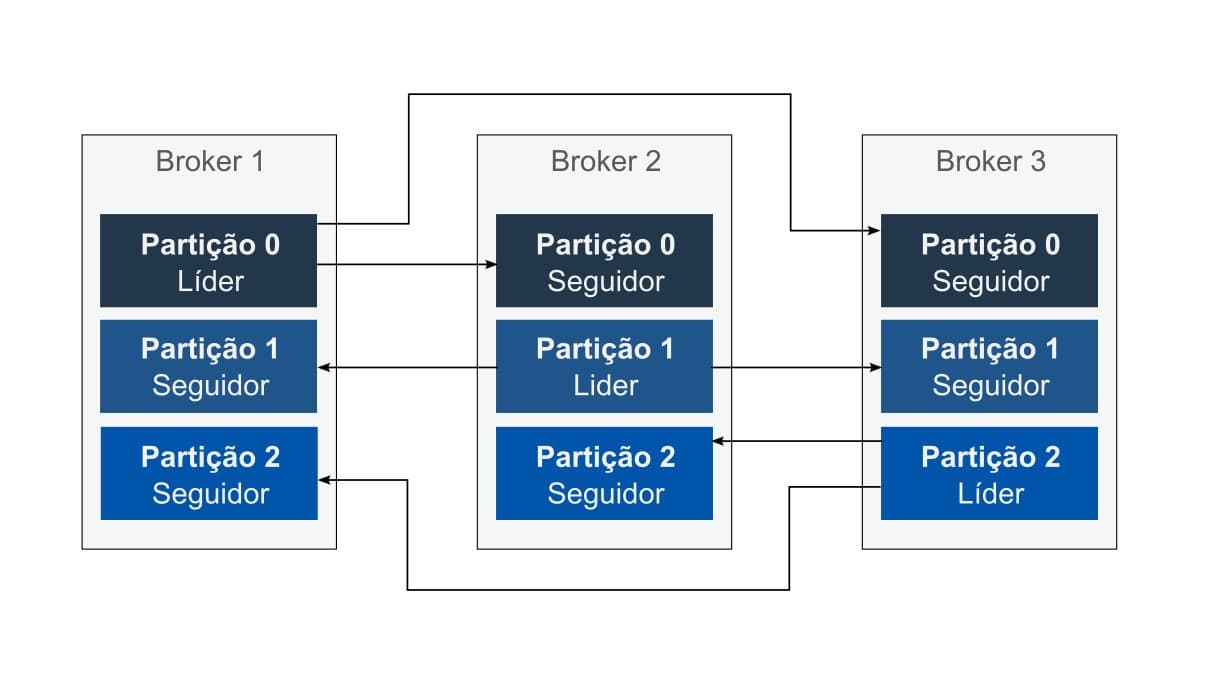
As partições de um tópico são distribuídas pelos nós do cluster e podem ser replicadas entre os nós para garantir redundância no serviço. Cada partição possui um nó eleito como líder que deve ser utilizado pelas aplicações ao ler e escrever eventos nesta partição. Quando um fator de replicação é configurado em um tópico, alguns nós são designados como seguidores de cada partição que o compõe, também chamados de In-Sync-Replica (ISR). Dessa forma, se um nó líder de determinadas partições é desligado ou perdido outros nós seguidores das mesmas partições pode ser eleitos como os novos líderes e continuar a operação sem perda de dados.
Producers e Consumer Groups .
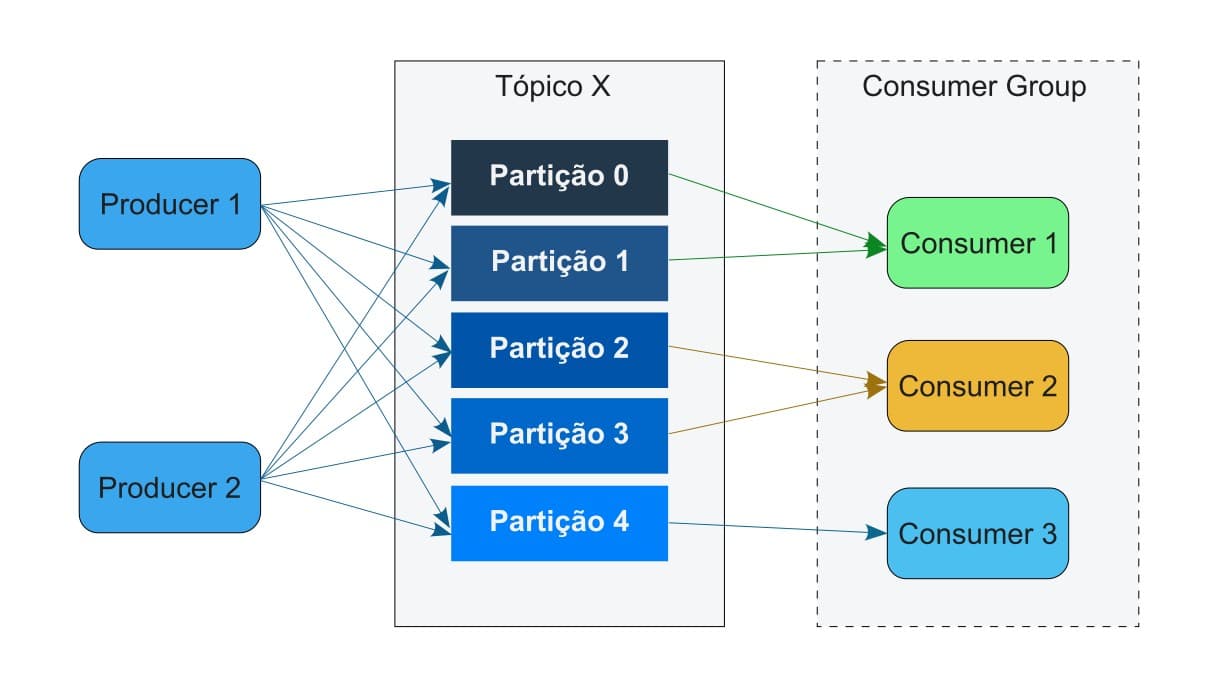
Ná terminologia do kafka, Producers são aplicações que publicam eventos, enquanto Consumers são aplicações que leem eventos. Apesar do nome, quando um consumer lê um evento ele não é consumido, como é feito em sistemas de fila como o RabbitMQ, ActiveMq e Amazon SQS. Um mesmo tópico pode possuir múltiplos producers e consumers. Consumers que fazem parte de uma mesma aplicação, como réplicas de um mesmo serviço, podem ser agrupados em um mesmo consumer group do Kafka. Cada consumidor em um consumer group recebe mensagens diferentes de um mesmo tópico, isso é possível pois cada partição de um tópico é designada a apenas um consumer de um consumer group, mas um consumer pode ser designado para várias partições. Isso faz com que o número de partições seja uma forma de unidade de paralelismo para os consumidores do kafka e está diretamente associada com o throughput que ele é capaz de entregar em um tópico. Isso também significa que o máximo de membros de um consumer group consumindo mensagens de um mesmo tópico é o número de partições daquele tópico. O kafka auto balanceia o consumer designado para cada partição de um tópico conforme os consumers em um consumer group aumentam ou diminuem. O fato de que é difícil alterar o número de partições após a criação de um tópico, juntamente com o fato de que elas são unidades fundamentais para garantir a capacidade de throughput e redundância do Kafka, faz com que este seja um dos pontos que devem ser "acertados de primeira" pelo desenvolvedor. Então escolha esse valor com sabedoria! Este post de blog da algumas dicas de como fazer essa escolha com consciência.
Agora que vimos em detalhes como o Kafka funciona vamos experimentar subir um cluster com um único nó localmente usando o docker compose. Abaixo está o modelo que vamos usar. Para executa-lo basta ter o docker instalado em sua máquina, criar um arquivo docker-compose.yaml em uma pasta qualquer com o conteúdo abaixo e executar o comando docker compose up de um terminal na pasta de destino do arquivo.
docker-compose.yml
version: '3.5'
services:
broker:
  image: apache/kafka:3.9.0
  container_name: broker
  environment:
    KAFKA_NODE_ID: 1
    KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: 'CONTROLLER:PLAINTEXT,PLAINTEXT_HOST_INTERNAL:PLAINTEXT,PLAINTEXT_HOST_EXTERNAL:PLAINTEXT'
    KAFKA_ADVERTISED_LISTENERS: 'PLAINTEXT_HOST_INTERNAL://broker:9093,PLAINTEXT_HOST_EXTERNAL://localhost:9092'
    KAFKA_PROCESS_ROLES: 'broker,controller'
    KAFKA_CONTROLLER_QUORUM_VOTERS: '1@broker:29093'
    KAFKA_LISTENERS: 'CONTROLLER://:29093,PLAINTEXT_HOST_INTERNAL://:9093,PLAINTEXT_HOST_EXTERNAL://:9092'
    KAFKA_INTER_BROKER_LISTENER_NAME: 'PLAINTEXT_HOST_INTERNAL'
    KAFKA_CONTROLLER_LISTENER_NAMES: 'CONTROLLER'
    KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
    KAFKA_NUM_PARTITIONS: 9
  ports:
    - "9092:9092"
kafka-ui:
  container_name: kafka-ui
  image: provectuslabs/kafka-ui:latest
  ports:
    - "8080:8080"
  environment:
    DYNAMIC_CONFIG_ENABLED: 'true'
Juntamente do Kafka estaremos subindo uma aplicação do Kafka-UI para que possamos interagir com o cluster, criando tópicos e eventos. Durante a criação do container de Kafka passamos algumas variáveis de ambiente responsáveis por configurar o broker. Se estivéssemos configurando o broker através de um arquivo de configuração as chaves dessas variáveis seriam equivalentes ao que usamos, mas em letra minúscula, sem o prefixo "KAFKA_" e com pontos no lugar de "_". Portanto a variável de ambiente "KAFKA_NODE_ID" equivale a configuração "node.id" por exemplo. Vamos repassar cada uma das configurações do broker? KAFKA_NODE_ID
Representa o id do nó no cluster que estamos inseridos
KAFKA_LISTENER_SECURITY_PROTOCOL_MAP
É uma lista de items separada por vírgulas. Cada item é par de chave e valor, sendo a chave o nome do listener que vamos criar e o valor o protocolo de comunicação. Estamos usando o PLAINTEXT como protocolo, mas em casos reais é recomendado utilizar um protocolo como SSL para criptografar os dados em trânsito.
Declaramos 3 listeners, PLAINTEXT_HOST_INTERNAL que pode ser visto internamente na rede do docker, PLAINTEXT_HOST_EXTERNAL que pode ser visto na rede da máquina que executa o docker pois estamos expondo a porta 9092 e por fim CONTROLLER que é o listener do controller que precisamos declarar separadamente. KAFKA_ADVERTISED_LISTENERS
São os listeners divulgados pelos nós do cluster para ajudar que os clientes encontrem outros nós
KAFKA_PROCESS_ROLES
Dita os papeis desse nó do cluster. No caso, como estamos utilizando o modo KRaft, esse nó atua como controller e como broker.
KAFKA_CONTROLLER_QUORUM_VOTERS
Indica os outros nós votantes em situações onde é necessário um consenso, como ao eleger um novo líder de uma partição. Como estamos criando um cluster com somente um nó, ele é o único informado.
KAFKA_LISTENERS
São todos os listeners declarados por este nó de cluster
KAFKA_INTER_BROKER_LISTENER_NAME
É o nome do listener usado para comunicação entre brokers do cluster, para tarefas como a de replicação de tópicos
KAFKA_CONTROLLER_LISTENER_NAMES
São os nomes dos listeners usados para comunicação do controller
KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR
É o fator de replicação de um tópico especial do kafka que armazena os offsets de cada consumer. Ele pode assumir o valor máximo equivalente ao número de nós brokers do cluster. Como vamos utilizar apenas um, seu valor deve ser 1.
KAFKA_NUM_PARTITIONS
Quando um tópico é criado automaticamente por consumer o Kafka usa essa configuração para determinar o número de partições padrão a ser utilizado.
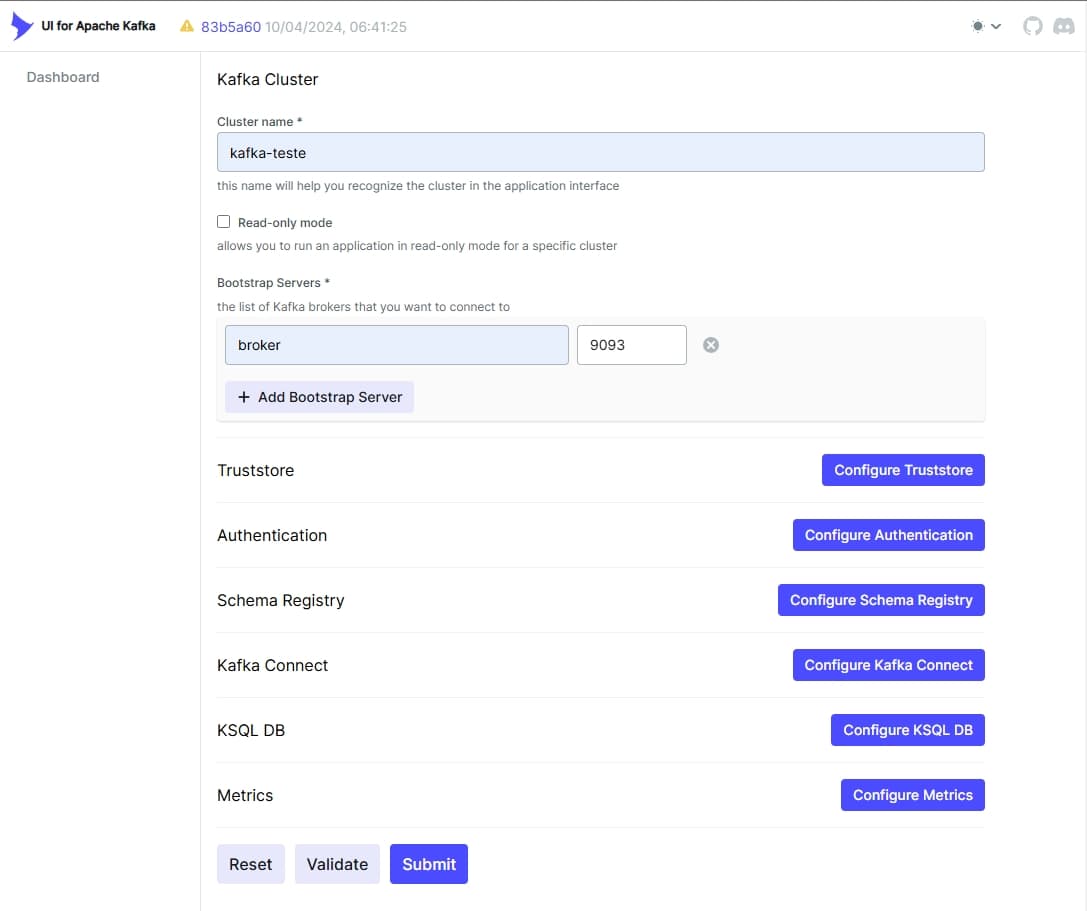
Após subirmos o broker e a instância do Kafka-UI podemos acessar http://localhost:8080 e preencher algumas configurações do Kafka-UI da seguinte forma.
Kafka-UI-1 .
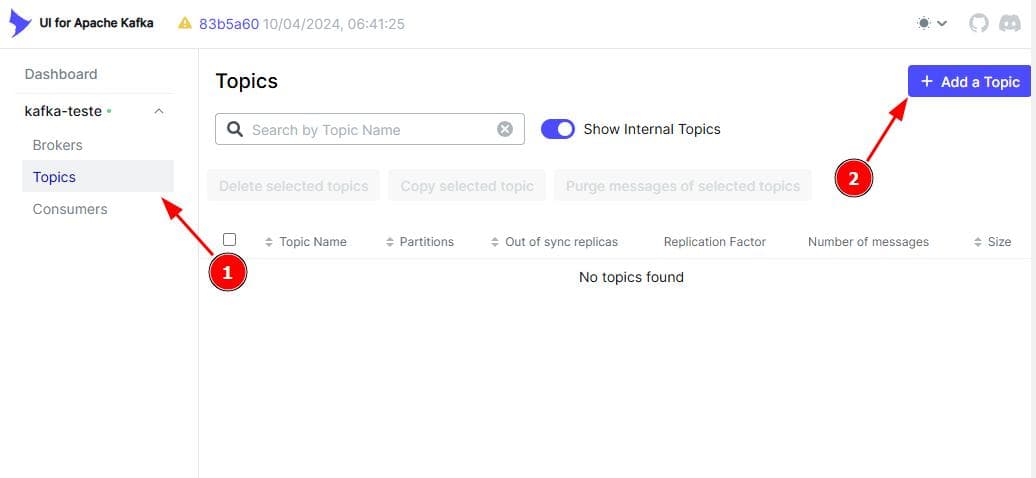
Ao clicarmos em "submit" podemos acessar os dados do broker configurado, clicar em "topics" e então em "Add a Topic" como na seguinte imagem:
Kafka-UI-2 .
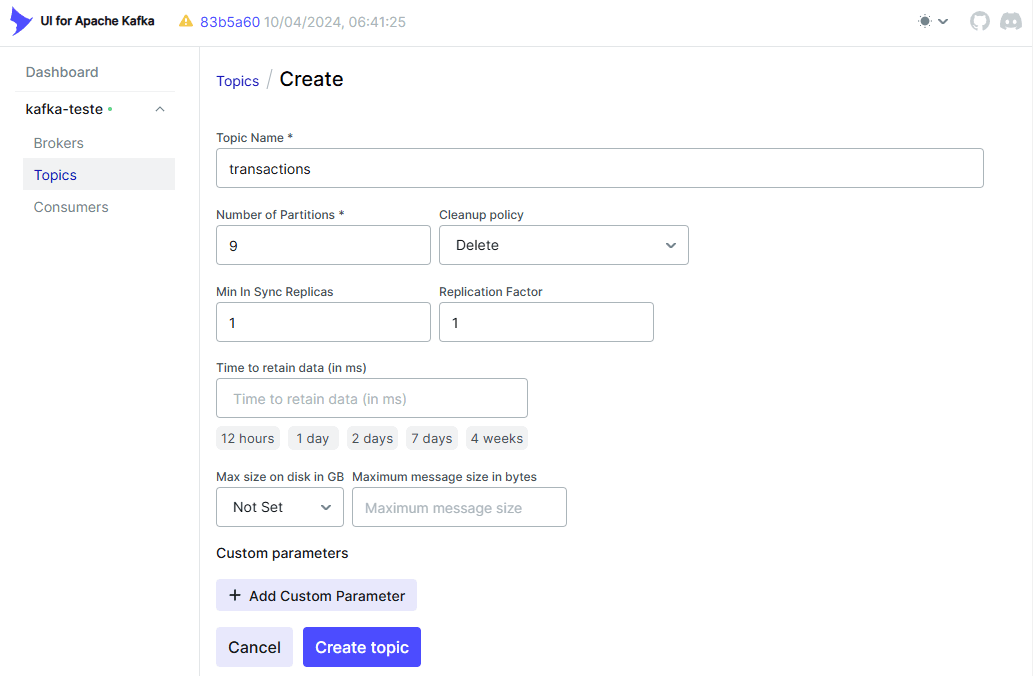
Para fins de teste vamos configurar um tópico chamado transactions, com 9 partições, fator de replicação 1 e o mínimo de 1 replica in Sync. Ao clicar em "Create topic" teremos criado nosso primeiro tópico!
Kafka-UI-3 .
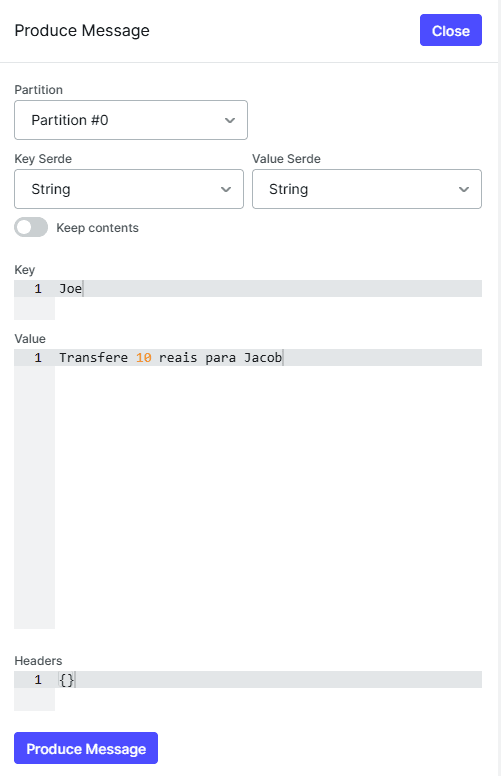
Ao entrarmos na página do tópico recém criado veremos um botão "Produce Message". Podemos clicar nele para abrir um menu e produzir nossa primeira mensagem.
Kafka-UI-4 .
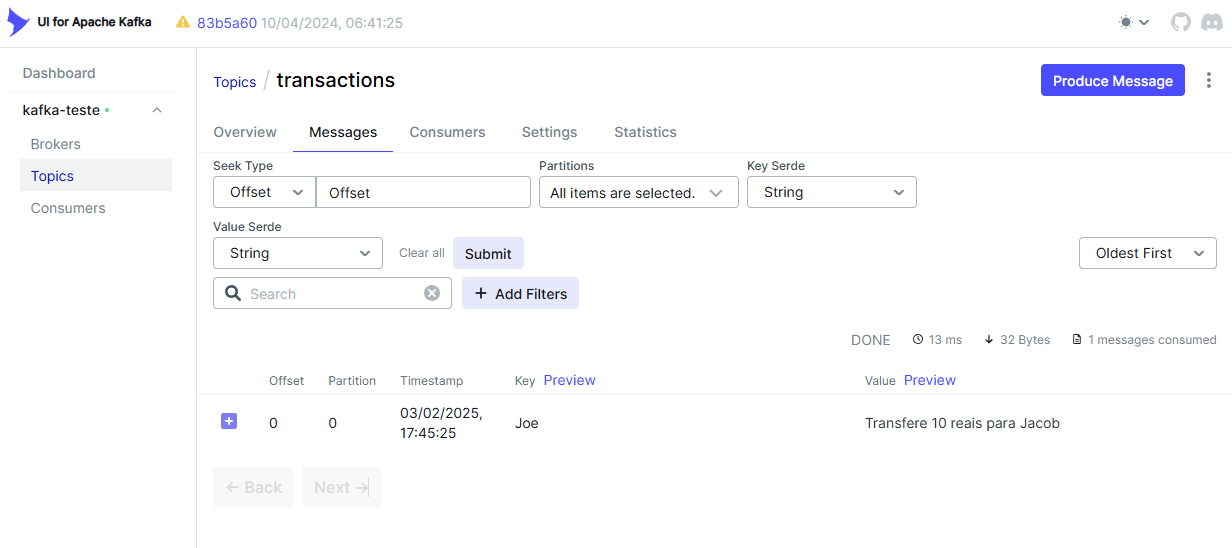
Após produzirmos a nossa mensagem ela pode ser observada na aba "Messages" do tópico.
Kafka-UI-5 .
Neste post, exploramos os principais conceitos do Apache Kafka e entendemos como ele possibilita a comunicação escalável, distribuída e tolerante a falhas entre processos. Vimos como os eventos são armazenados e organizados em tópicos e partições, garantindo paralelismo e ordenação, além de como os brokers, producers e consumers interagem para tornar essa arquitetura eficiente. Além da teoria, colocamos a mão na massa e configuramos um ambiente Kafka localmente, utilizando Docker e Kafka-UI para visualizar e interagir com o sistema de forma prática. Esse primeiro contato com o Kafka é fundamental para entender seu funcionamento e suas vantagens, mas há muito mais a explorar! Nos próximos passos, podemos aprofundar no uso de producers e consumers com código, explorar como tornar a comunicação com os brokers criptografada, como integrar com um Schema Registry para garantir a uniformidade das mensagens em um tópico e muito mais. Se você deseja trabalhar com sistemas distribuídos e processamento de eventos em tempo real, dominar o Kafka será um grande diferencial!